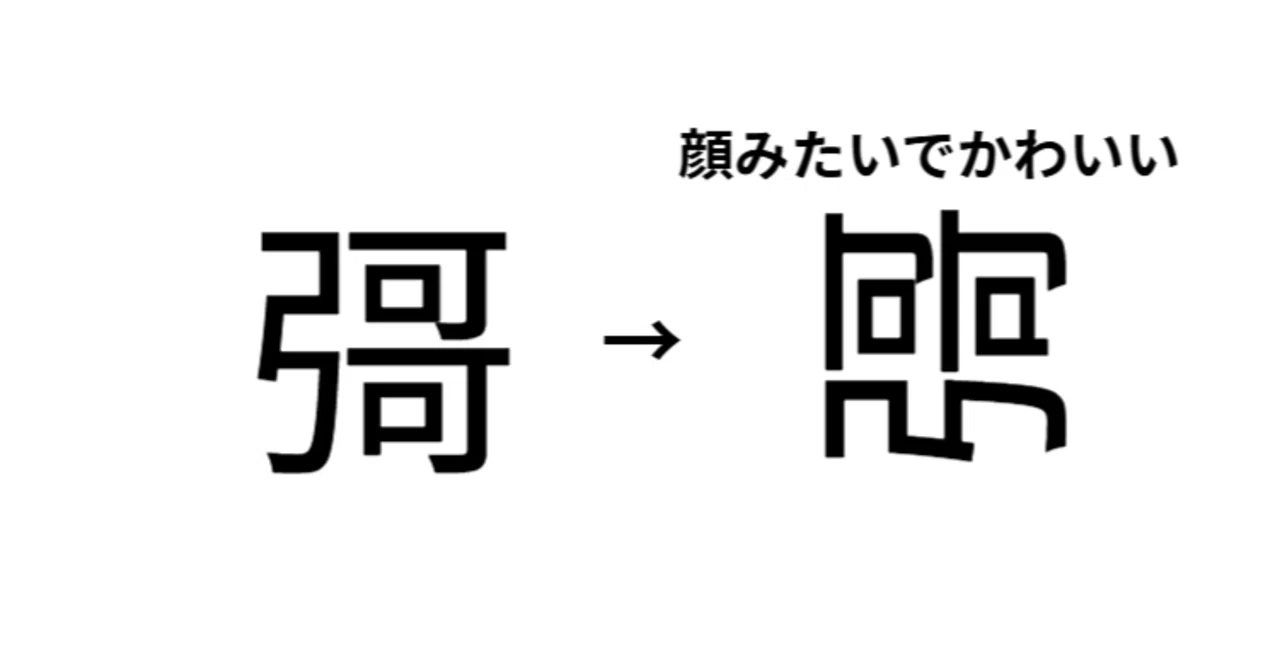
幽霊文字一覧の真相!JIS規格に潜む「彁」「妛」の読み方と誤写の全貌
パソコンやスマートフォンの文字変換候補に現れる、誰も読めず、辞書を引いても意味すら載っていない謎の漢字をご存じでしょうか。日本の情報処理黎明期に規格化された文字セットの中に、正体不明のまま紛れ込んだこれらの一群は、言語学者やIT関係者の間で「幽霊文字(ゴーストキャラクター)」と呼ばれています。
なぜ実在しない架空の文字が国家規格であるJIS漢字に採用され、現在世界中で使われるUnicodeにまで残存しているのでしょうか。長年にわたる執念の調査報告によって判明した誤写・誤植の経緯から、2026年現在もなお唯一典拠が掴めない最大のミステリー「彁」の真相まで、その歴史的背景を徹底検証します。
📌 【この記事の重要ポイントまとめ】
- 要点1:幽霊文字とは、1978年のJIS規格(JIS C 6226)策定時に典拠不明のまま登録された約60字の漢字群を指す。
- 要点2:混入の原因は、地名や人名資料のマイクロフィルム複写や切り貼り作業に伴う「文字の擦れ・ツギハギ・誤写」による人為的ミス。
- 要点3:国際規格Unicodeとの互換性維持のため現在も削除されず、デジタル空間の歴史的遺産・ネットカルチャーとして定着している。
【全貌公開】代表的な幽霊文字一覧表|読み方・意味・典拠の調査結果
1978年に制定された第1次JIS漢字(JIS C 6226、現JIS X 0208)には、第2水準漢字を中心に、漢和辞典の最高峰とされる『大漢和辞典』にすら記載のない文字が60字以上含まれていました。これらは長らく「正体不明の文字」とされていましたが、1997年に国語学者・笹原宏之氏(現・早稲田大学教授)が発表した大規模な調査報告によって、その大半の由来が判明しています。
調査によって判明した代表的な幽霊文字の一覧と、混入の経緯・読み方・典拠の最新データをまとめました。
| 漢字 / Unicode | 想定される読み・意味 | 調査で判明した典拠・本来の文字 | 編集部の見解・発生要因 |
|---|---|---|---|
| 彁 (U+5F41) | 音:カ、セイ 意味:不明 | 完全な典拠不明 (古今東西の全文献に存在せず) | 「彊」「哥」の誤写や「配」「蚕」の写植ミス説など諸説あるが、真相は未解明の最高難度文字。 |
| 妛 (U+599B) | 訓:あけび 音:シ | 国字「𡚴」(あけび) (『国土行政区画総覧』掲載の滋賀県地名) | 「山」の下に「女」と「一」を組み合わせる際、元原稿の切り貼りの継ぎ目を「一」と誤認して作成された。 |
| 暃 (U+6683) | 音:ヒ 意味:日の光(推測) | 「罪」または「曐」(星の異体字) (『国土行政区画総覧』福島県地名) | マイクロフィルムの黒潰れや汚れにより「四」の部分が「日」に見間違えられた誤写典型例。 |
| 椦 (U+6916) | 音:ケン 意味:木の名(推測) | 国字「橳」(ぬで) (群馬県前橋市の地名「橳島」) | 右側の「勝」の崩し字を「巻」と読み違え、原簿作成時に新字として誤登録された。 |
| 駲 (U+99F2) | 音:シュウ、ジュン 意味:不明 | 「馴」または「𩢿」 (北海道のアイヌ語由来地名) | 印刷のかすれによって旁(つくり)の「川」が「刀+口」のように分断されて読み取られた。 |
| 蟐 (U+87D0) | 音:ジョウ、サン 意味:虫の名(推測) | 「蟷」(とう)または「蟇」(ま) (『国土行政区画総覧』記載の地名) | 複雑な画数を持つ虫偏の漢字が縮小コピー時に潰れ、別の偏旁として転記された。 |

なぜ実在しない漢字がJIS規格に混入したのか?70年代の現場と誤写の真相
実在しないはずの漢字が、なぜ国家規格であるJIS漢字コードに正式登録されてしまったのか。その原因は、1970年代後半の日本におけるコンピュータ漢字規格の策定作業の過酷な現場環境にありました。
1978年に制定されたJIS C 6226は、行政機関や民間企業で電算処理を行うための共通規格として急ピッチで策定が進められました。当時の委員会は、網羅的な漢字セットを構築するために以下の4つの大規模資料を統合・収集しました。
- 行政管理庁基本漢字(1975年):住民基本台帳や税務処理用の行政文字
- 国土行政区画総覧(国土地理協会):全国の市区町村・大字・小字を網羅した地名便覧
- 日本生命人名表:生命保険加入者の膨大な名簿データ
- 電電公社字種表:電話帳管理・通信事業用の文字コード
当時、デジタルテキストデータベースは存在しません。数万点に及ぶ漢字用例の収集は、紙の印刷物のコピーや縮小マイクロフィルムを目視で確認し、ハサミで切り取って台紙に糊付けする手作業で行われていました。
劣化した印刷のかすれ、トナーの飛び散り、文字の潰れ、さらには切り貼り原稿の継ぎ目に入った影の線。これらを当時の作業員やフォント制作の写植職人が「未知の異体字・外字」と判断し、そのまま正確に清書・トレースしてしまったことこそが、幽霊文字を生み出した構造的要因です。
「妛」と「彁」の決定的な違い|唯一手がかりゼロの「最強の幽霊文字」とは
幽霊文字と呼ばれる文字の中でも、特筆すべき対比を見せるのが「妛(あけび)」と「彁(か)」の2文字です。
「妛」の真相:写植原稿のツギハギが生んだ幻の国字
滋賀県蒲生郡日野町に実在する地名「𡚴山(あけびやま)」。本来の文字は「山」の下に「女」を書く国字「𡚴」でした。しかし『国土行政区画総覧』の原稿を作成する過程で、文字を切り貼りした台紙の合わせ目の影が横線「一」として写り込み、「山+女+一」という未知の構成文字「妛」として誤認登録されました。典拠が特定されたことで、この文字は「人為的ミスの決定的な物的証拠」として言語学史に名を刻んでいます。
「彁」の謎:2026年現在も典拠が一切存在しない孤高の文字
一方で、幽霊文字の中で異彩を放ち続けているのが「彁」です。国立国語研究所による12年間の追跡調査において、全国2,600以上の自治体資料、電話帳、歴史的文献、古文書のすべてを精査したものの、典拠となった元資料の痕跡すら一切見つかりませんでした。
専門家の間では、「彊(きょう)」の旁を誤って写した説、「哥(か)」に弓偏を誤合成した説、あるいは「配」や「蚕」の文字コード割り当て時の入力ミス説など複数の仮説が議論されていますが、決定打はいまだ存在しません。漢字の形を保ちながら、地球上のいかなる言語文献にも使われた実績がない「彁」は、文字コードの暗黒面に生まれた特異点と言えます。

【実態検証】Unicodeが引き継いだ「消せない幽霊」と現代ネットカルチャーの熱狂
「誤って登録された文字なら、規格を改定して削除すればよいのではないか」という疑問が生じるのは自然なことです。しかし、デジタル情報処理の厳格な原則がそれを阻んでいます。
削除できない理由:Unicodeのラウンドトリップ互換性
世界規格であるUnicodeは、過去の既存文字セット(JIS規格など)との間で文字データを双方向に変換した際、情報が欠落・変化しない「ラウンドトリップ互換性」を最優先事項として設計されています。一度JISに登録され、Unicodeにマッピング(彁=U+5F41、妛=U+599B)された文字を削除してしまうと、過去に作成された文書ファイルやデータベースの互換性が崩壊します。そのため、実在しない文字であっても未来永劫システムから消去することは不可能な構造になっています。
ネットカルチャーにおける幽霊文字の再解釈
この「電脳空間に閉じ込められた消せないエラー」という特異な背景は、ネットコミュニティやクリエイターの間で独自の魅力を放っています。
- ARG(代替現実ゲーム)や怪談・SCPの題材:「意味を持たない文字」「存在しないはずの符号」という不気味さが、デジタルホラーやミステリー作品の暗号として活用されています。
- プログラミングのエッジケーステスト:通常の漢字処理ルーチンが未知のグリフを正常にレンダリング・パースできるかを確認する境界値テスト文字としてエンジニアに重宝されています。
- フォントデザイナーの遊び心:実在しない文字であるため、各フォントベンダーは「彁」の書体をデザインする際、既存の部首構成から推測した独自のバランスでグリフを作成しています。
一般に知られていない盲点とネットの誤解|「幽霊文字=完全な創作」ではない
インターネット上では、幽霊文字に関して「当時の策定委員がいたずらで勝手に作った」「隠しメッセージが仕込まれている」といった都市伝説が語られることがありますが、これらは明確な誤解です。
誤解1:委員が意図的に創作した架空文字である
幽霊文字の約9割は、前述の通り実在する地名や人名の「印字の潰れ」「切り貼り原稿の影」「類似文字の読み違え」に起因しています。委員が悪意や遊び心で創作した文字ではなく、紙からコンピュータへと移行する過渡期のスキャン技術の限界が生み出した産業的アクシデントでした。
誤解2:幽霊文字は一切入力・表示できない
多くの日本語入力システム(IME)では、標準的な読み仮名を入力しても幽霊文字は候補に出にくい仕様になっています。しかし、文字コード(Unicode値)を直接指定して変換するか、「部首合成検索」や「文字パレット」を使用することで、現在市販されているほぼすべてのPCやスマートフォンで正常に入力・表示が可能です。
【プロの結論】デジタル化の黎明期が遺した教訓と文字コードの文化的価値
幽霊文字は、単なる「昔のエンジニアによる入力ミス集」ではありません。アナログの手作業とデジタル電算化が交錯した昭和50年代の労働環境と、当時の情報技術の限界を生々しく記録した文化的オーパーツです。
現代のAIや高度なOCRシステムにおいても、入力データの品質(データクレンジング)を怠れば、予期せぬアーティファクトが半永久的にシステム内部へ固定化されてしまう危険性は常に存在します。幽霊文字が残した歴史的経緯は、最新のデータサイエンスやシステム設計に携わる現代の開発者にとっても、極めて示唆に富む教訓を与えています。
【幽霊文字一覧】に関するよくある質問(FAQ)
Q1:幽霊文字をPCやスマートフォンで実際に入力・変換する方法はありますか?
A1:文字コードを直接入力する方法が最も確実です。Windowsであれば「5F41」と入力して[F5]キー(またはIME手書き入力・文字一覧)、Mac/iOS/Androidでは文字ビューアや「単語登録」アプリを利用してUnicodeから呼び出すことで、画面上に入力・表示が可能です。
Q2:幽霊文字を子供の命名(人名)に使うことは法律上できますか?
A2:法律上、命名に使用することはできません。戸籍法において子の名に使用できる漢字は「常用漢字」および「人名用漢字」に限定されています。幽霊文字はいずれにも含まれていないため、出生届を提出しても不受理となります。
Q3:今後、JIS規格やUnicodeから幽霊文字が正式に削除される可能性はありますか?
A3:削除される可能性はほぼゼロです。文字コードの国際規格では、既存のデジタル資産や過去データとの上位互換性(ラウンドトリップ互換性)を厳格に保持することが定められており、たとえ誤字であっても一度割り当てられたコードポイントは永久に保持されます。
まとめ:幽霊文字が問いかけるデジタル社会の記憶と未来
1978年のJIS規格策定における極限の手作業から生まれ、今なお世界中のOSやデバイスの奥深くに静かに格納されている幽霊文字。その多くは誤写という人間臭いミスの産物でありながら、「彁」のように完全なミステリーを残す文字も存在します。
完全無欠に見える現代のデジタルインフラの足元には、黎明期の試行錯誤と偶然が生んだ不思議な歴史が刻まれています。キーボードの奥に潜むこれらの文字は、データ社会における「記憶の不可逆性」を今も静かに語りかけています。 (出典: 幽霊 文字 一覧(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。
